履歴の留保:後の系列監査で、関連細胞系列が区画をまたいだ分割が18/20でした。数値の誤りとは断定しませんが、系列独立の評価としては扱えません。現在の系列除外後3モデル比較と直接比較しないでください。
分け方を変えても、良くなる?
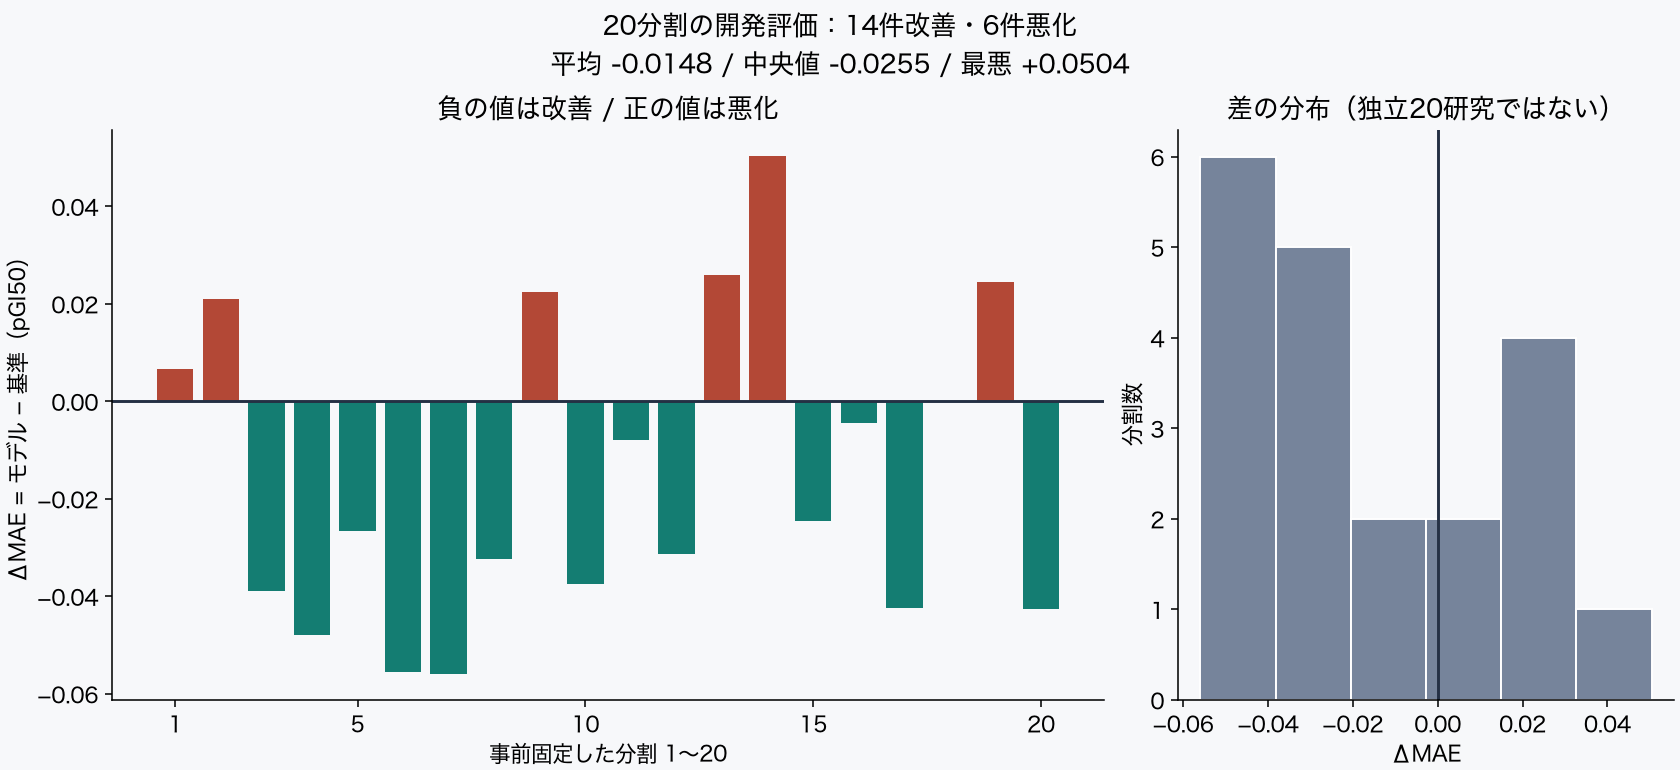
20分割では14件が改善・6件が悪化。
平均では少し改善しましたが、固定保留株では悪化。
計算が予測した「細胞株実験データとのずれ」を検証しています。薬が人に効く証明や、新薬発見ではありません。
まず、何を試したのか
学習データの薬剤平均を基準に、組織分類の補正を足す固定モデルを比較しました。同じ6薬剤×55細胞株の公開集約データを使い、モデルは変えていません。追加データ取得・有料計算・GPU・常駐処理はありません。
計算前に20seed(20262001〜20262020)と保留株を固定し、設定とコードをcommitしました。今回は全55株のうち8株を保留し、残る47株で学習31株/校正8株/開発評価8株に分割します。
20件は同じデータを繰り返し分けた開発評価です。独立した20研究や、未知の最終テストではありません。前回5分割と今回はコホートや校正株数が異なるため、25件を一つの分布に合算しません。
物差しと、結果の意味
MAEは予測と実験値のずれの平均。小さい方が良い数です。今回はΔMAE = モデルMAE − 基準MAE。負なら改善、正なら悪化です。14/20(70%)は分割での勝率であり、薬が効く確率ではありません。
| 開発評価の集計 | 平均 | 中央値 | 最小〜最大 |
|---|---|---|---|
| 基準MAE | 0.5975 | 0.6024 | 0.4624〜0.6772 |
| モデルMAE | 0.5826 | 0.5960 | 0.4198〜0.6507 |
| ΔMAE | -0.0148 | -0.0255 | -0.0559〜+0.0504 |
| 基準RMSE | 0.7938 | 0.7955 | 0.6248〜0.8780 |
| モデルRMSE | 0.7776 | 0.8011 | 0.5765〜0.8540 |
全20seedのMAE・RMSE・区間を確認する
| seed | 基準MAE | モデルMAE | ΔMAE | 基準RMSE | モデルRMSE | 細胞同時被覆率 | 区間半幅 |
|---|---|---|---|---|---|---|---|
| 20262001 | 0.6102 | 0.6168 | +0.0066 | 0.8329 | 0.8250 | 100.0% | ±3.063 |
| 20262002 | 0.5917 | 0.6127 | +0.0210 | 0.7813 | 0.7808 | 100.0% | ±2.941 |
| 20262003 | 0.5942 | 0.5553 | -0.0389 | 0.7763 | 0.7453 | 87.5% | ±2.137 |
| 20262004 | 0.6332 | 0.5853 | -0.0479 | 0.8414 | 0.7959 | 50.0% | ±1.949 |
| 20262005 | 0.6772 | 0.6507 | -0.0266 | 0.8697 | 0.8422 | 87.5% | ±2.356 |
| 20262006 | 0.6608 | 0.6053 | -0.0555 | 0.8780 | 0.8321 | 100.0% | ±2.897 |
| 20262007 | 0.5789 | 0.5229 | -0.0559 | 0.7566 | 0.7348 | 87.5% | ±2.359 |
| 20262008 | 0.6754 | 0.6431 | -0.0323 | 0.8474 | 0.8063 | 100.0% | ±2.540 |
| 20262009 | 0.5410 | 0.5635 | +0.0225 | 0.8077 | 0.8082 | 87.5% | ±2.310 |
| 20262010 | 0.6299 | 0.5925 | -0.0374 | 0.8576 | 0.8104 | 62.5% | ±2.108 |
| 20262011 | 0.5452 | 0.5373 | -0.0079 | 0.7195 | 0.7080 | 87.5% | ±1.967 |
| 20262012 | 0.6383 | 0.6071 | -0.0313 | 0.7582 | 0.7415 | 100.0% | ±2.454 |
| 20262013 | 0.5150 | 0.5409 | +0.0259 | 0.6641 | 0.6833 | 87.5% | ±1.792 |
| 20262014 | 0.5862 | 0.6367 | +0.0504 | 0.8220 | 0.8540 | 87.5% | ±2.527 |
| 20262015 | 0.6239 | 0.5994 | -0.0245 | 0.8572 | 0.8421 | 50.0% | ±1.644 |
| 20262016 | 0.6150 | 0.6106 | -0.0044 | 0.7678 | 0.7622 | 100.0% | ±2.020 |
| 20262017 | 0.6218 | 0.5794 | -0.0424 | 0.8621 | 0.8363 | 50.0% | ±1.743 |
| 20262018 | 0.5545 | 0.5544 | -0.0002 | 0.7673 | 0.7571 | 100.0% | ±2.727 |
| 20262019 | 0.5945 | 0.6191 | +0.0246 | 0.7834 | 0.8106 | 87.5% | ±2.297 |
| 20262020 | 0.4624 | 0.4198 | -0.0426 | 0.6248 | 0.5765 | 100.0% | ±2.474 |
固定保留8株はどうだったか
20分割では使わない8株に対し、固定した手順で最後に1回評価しました。学習39株・校正8株・保留評価8株で、基準MAE 0.4650 → モデル 0.4845、差は +0.0195(悪化)でした。
この8株は過去5分割のtestではありませんが、過去の学習・校正には利用されていました。今回のフローでは固定保留しても、新しい独立データによる厳密な最終検証とは言えません。その最終検証は未実施です。
開発評価の平均改善だけでは十分ではないことが、保留株での悪化からも分かります。この結果を見て有利なモデルへ切り替えたり、保留株を選び直したりしていません。
「自信の幅」は当たっていたか
細胞株の全6薬剤を同時に覆う被覆率は開発評価で平均85.6%、最小50.0%、最大100%。8評価株なので1株で12.5ポイント変わる粗い割合です。
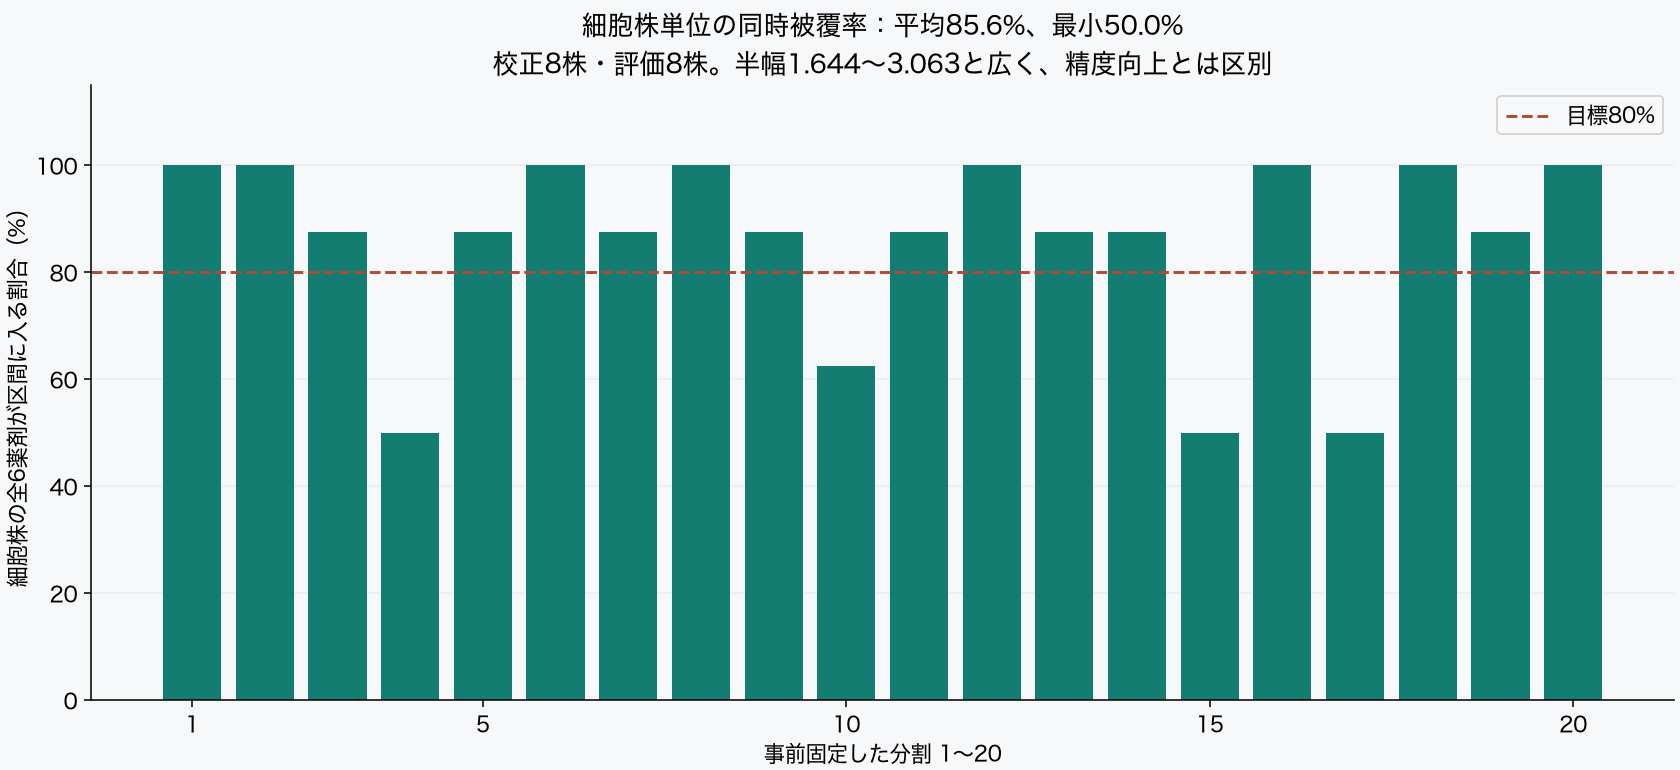
校正8株では有限標本補正の80%分位点が8番目、つまり最大残差になります。区間半幅は±1.644〜±3.063 pGI50と広く、前回9校正株の結果と単純に比較できません。保留株でも100%被覆しましたが、半幅±2.756と広いため、精度向上の証明ではありません。
被覆率を捏造せず、既存の校正区間を実際に計算しました。ここでの観測被覆率は厳密な分布自由の保証や臨床安全性の保証ではありません。
専門知識と、その説明
GI50・pGI50・MAE・RMSEの読み方
- GI50(50%増殖抑制濃度)
- 培養細胞の増殖を50%抑制する濃度。死亡率・治癒率・生存率・IC50と同じ指標ではありません。
- pGI50 = −log10(GI50 [M])
- モル濃度を対数変換した物差し。大きいほど低濃度で増殖抑制されたことを表します。1つの予測で1ずれると濃度比は10倍。MAE0.6は60%効いたという意味ではありません。
- MAE / RMSE
- MAEは絶対誤差の平均。RMSEは二乗誤差の平均の平方根で、大きな外れをより強く反映します。
- ΔMAE / 勝率
- モデル−基準の差。負なら改善です。勝率はΔ<0の開発分割割合で、治療成功率でも独立研究の成功率でもありません。
分割・モデル固定・不確実性の計算方法
細胞株IDを組織別にSHA256で並べ替え、同じ細胞株の全薬剤を同一分割へ入れます。薬剤は各分割で共通なので、評価対象は既知薬剤に対する細胞株応答です。未知化合物への一般化は測りません。
薬剤学習平均に組織の残差和/(行数+10)を加える固定モデル。係数10・20seed・保留選択seed20262998・最終校正seed20262999を結果前に固定。今回は調整を行わず、validationでハイパーパラメータを選択する工程はありません。将来調整する場合はtrain内部のgrouped CVだけで行い、最終コホートと分離します。
校正細胞ごとの全薬剤最大絶対残差に対し、ceil((n+1)×0.8)番目の値を区間半幅にします。今回n=8なので最大の8番目。有限の区間を出せない小標本では未対応状態を返し、被覆率を作りません。組織層化・集約条件の不均一性・過去利用歴により、保証された被覆率とは主張しません。
20分割は同じ47株の再配置で、各株が繰り返し評価されます。平均・中央値・最悪・勝率は記述統計。独立20試行としての信頼区間や有意差検定は付けていません。
由来・前処理・再現性・利用条件
NCI/DTP公式GI50 XML。既知6薬剤について最大NumExpの濃度群を値に依存せず選び、補助群を除外。6薬剤共通の55株を使い、前立腺2株は群が小さく除外。endpoint GI50、単位log10(M)、細胞株の重複・分類、入力SHA256を検証しました。最高濃度・実験数はJSONに記録。
旧5評価のtestを除く候補から組織ごとに1株を固定保留しました。全55株が過去の評価フローで使用済みという履歴を残しています。設定・実験コードをcommitしてから評価し、保留株IDと分割割当は非公開で保存します。公開するのは集計結果・方法・hashだけです。
CPU1スレッド・低優先度、総60秒上限。今回は計測区間0.0319秒(CLI起動・描画・公開ビルドは除外)。保存済み約1.16MBを使用し、新規データ取得・有料計算なし。コード本体は非公開なので、公開閲覧者の完全な実行環境を提供したとは主張しません。
nice -n 15 python3 robust.py evaluate --config experiments/configs/robust-20.json --out runs/robust-20
元データ出典:NCI/DCTD Data / Compound Inhibition Bulk Data Download。NCI一般再利用方針を、データ固有の再配布許可とはみなしません。生XML・細胞株別表・非公開コードは掲載しません。
次に必要な検証とロードマップ
第1段階:評価強化(今回実装) — 固定20seed、全seed集計、ΔMAE分布、固定モデル、保留株の過去利用歴を可視化。独立した真の最終テストは未取得です。さらに同じseedを増やすだけでは、この不足を解消しません。
第2段階:分子特徴(次の別PR・未実装) — NCI-60公式発現データの利用条件・版・hashを確認し、厳密な細胞株ID対応表で結合。標準化・欠損補完・PCAはtrainだけでfitし、Ridgeのλはtrain内部grouped CVで選びます。drug_mean / tissue / molecularを同じ固定評価条件で比較し、新たな独立最終テストをどう確保するか先に定義します。
以降の計画(未実装) — 薬剤数十〜100への拡張前にendpoint、濃度上限、実験数、欠損を統一するingest。薬剤一般化にはdrug特徴を追加し、GI50の打ち切りはcensored/interval層で扱う。単剤→用量反応→時間→併用Bliss/Loewe/HSA→PK/PDと段階的に進めます。
将来層の用語を平易に読む
PCAは多くの発現特徴を少数の軸にまとめる方法。Ridgeは係数を縮めて過学習を抑える回帰で、λは縮める強さ。censoredは測定上限などで本当の値が範囲としてしか分からない状態。Blissは独立作用、Loeweは用量の等価性、HSAは優れた単剤を基準にする併用比較。PKは体内濃度の時間変化、PDは濃度と反応の関係です。今の集約GI50だけではこれらを実証できず、今は計画に留めます。
モデルの改善、薬剤の増量、用量反応や併用の計算は、臨床治療予測や合成・実体実験の指示とは区別します。
記録と旧結果
全20seedと保留結果の集計JSON / 結果Markdown / 前回5分割 / 初回2分割
2026-10-06:3追加分割を公開後、評価強化へ移行。既閲覧の5分割は履歴として保存し、今回20分割とは合算しません。