結果と、読み方を残す。
組織の情報を足すと、予測は良くなる?
5通りの分け方で、3件は改善・2件は悪化。
いつも正確になるとは、まだ言えません。
既知薬剤の「細胞株実験データに対する予測のずれ」を比べています。人に薬が効くこと、新薬が見つかったことを示す結果ではありません。
まず、何を試したのか
公開された細胞株の実験結果を「答え」として、計算で予測した数値と比べます。基準は、学習に使った細胞株での薬剤ごとの平均。比較モデルは、その平均に組織分類による補正を足したものです。
前回と同じデータ・モデルを使い、学習用と評価用の分け方だけを3通り追加しました。追加seedは計算前に20261006・20261007・20261008と固定。良い結果だけを選び直していません。
試した回数は増えましたが、実験データは増えていません。5分割は同じデータを再配置しているので、独立した5つの研究の再現ではありません。
物差しは「予測のずれ」
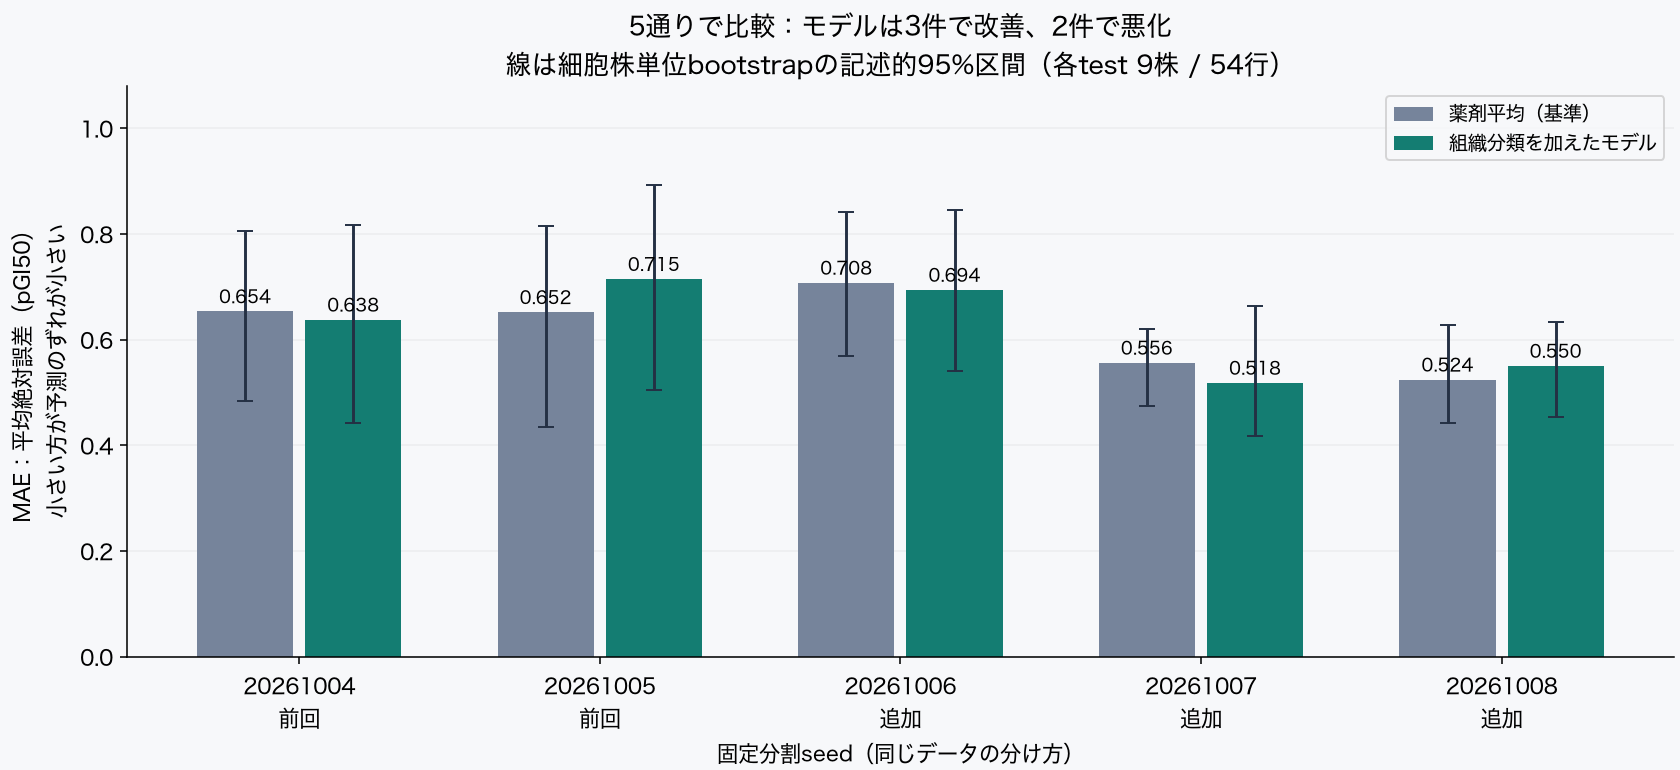
MAE(平均絶対誤差)は、予測と実験値のずれの大きさを平均した数です。小さい方が良い値です。「0.65」は薬が65%効いたという意味ではありません。
| 分割seed | 基準MAE | モデルMAE | 差:モデル−基準 | 基準 / モデルRMSE |
|---|---|---|---|---|
| 20261004 / 前回 | 0.654 | 0.638 | -0.016(改善) | 0.829 / 0.825 |
| 20261005 / 前回 | 0.652 | 0.715 | +0.063(悪化) | 0.866 / 0.906 |
| 20261006 / 追加 | 0.708 | 0.694 | -0.013(改善) | 0.890 / 0.877 |
| 20261007 / 追加 | 0.556 | 0.518 | -0.038(改善) | 0.702 / 0.671 |
| 20261008 / 追加 | 0.524 | 0.550 | +0.026(悪化) | 0.686 / 0.703 |
改善幅も悪化幅も小さく、どの分割でも改善するわけではありません。現時点の結論は「組織情報による安定した改善は未確認」です。改善3/5は、患者に効く確率60%という意味ではありません。
「自信の幅」は当たっていたか
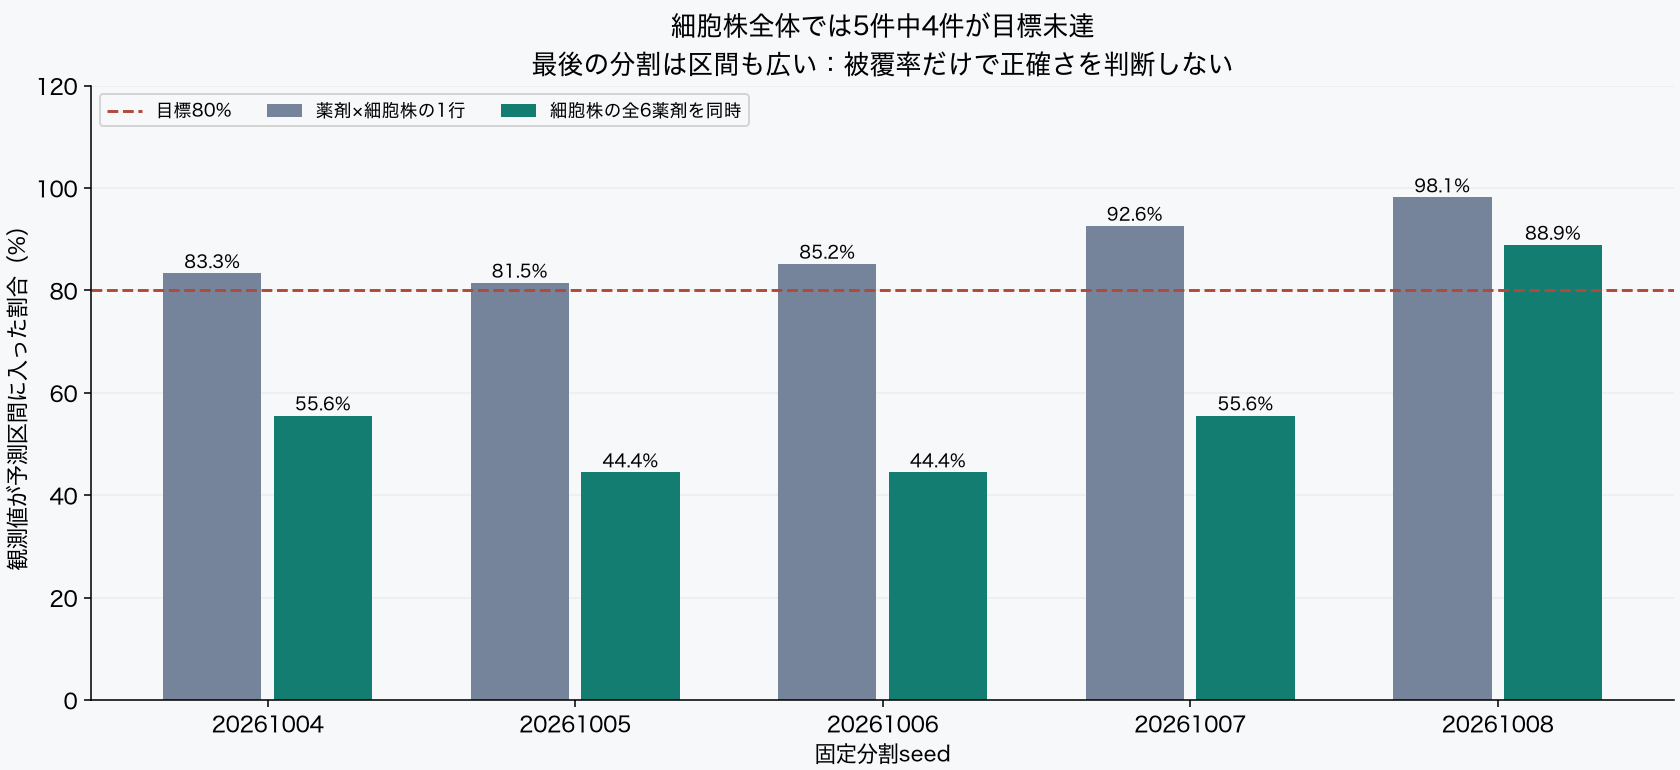
予測を1点だけでなく範囲として出し、実験値がその範囲に入った割合を調べました。80%を目標にしましたが、細胞株の全6薬剤を同時に覆う率は5件中4件で目標未達でした。
専門説明:区間の幅と被覆率を確認する
| 分割seed | 区間の半幅(pGI50) | 行被覆率 | 細胞株の全薬剤同時被覆率 |
|---|---|---|---|
| 20261004 | ±1.071 | 83.3% | 55.6% |
| 20261005 | ±1.179 | 81.5% | 44.4% |
| 20261006 | ±1.214 | 85.2% | 44.4% |
| 20261007 | ±1.259 | 92.6% | 55.6% |
| 20261008 | ±1.777 | 98.1% | 88.9% |
最後の分割の半幅は±1.777と広くなっています。広い区間は観測値を覆いやすい一方、予測の絞り込みには弱くなります。9株の校正・9株のtestによる観測割合であり、厳密な被覆保証や臨床安全性の区間ではありません。
専門知識と、その意味
用語を省かず、数字の意味を併記します。
- 細胞株
- 実験で培養される細胞の系統です。ここではがん細胞株の公開実験集約値を使っています。患者や人体そのものの応答とは異なります。
- GI50:50%増殖抑制濃度
- 細胞の増殖を50%抑制するために必要な濃度。低い濃度で抑制されたほど値は小さくなります。死亡率・治癒率・IC50・生存率と同じ指標ではありません。
- pGI50:−log10(GI50 [M])
- 濃度をモル単位Mに揃えて対数変換した物差し。大きいほど低濃度で増殖抑制されたことを表します。1つの予測でpGI50が1ずれると、濃度の比は10倍になります。集約MAEを全ての予測の同じ濃度誤差だとは解釈しません。
- MAE:mean absolute error
- 各行の |予測pGI50−観測pGI50| を平均。方向を打ち消さず、典型的な誤差の大きさを示します。
- RMSE:root mean squared error
- 各誤差を二乗して平均し、その平方根を取ります。MAEより大きな外れを強く反映するため、併せて見ます。
- baseline(基準モデル)
- 学習データだけで計算した薬剤平均。組織分類モデルが、単純な平均からどれだけ良くなったかを比較する相手です。
- seed(固定分割番号)
- 細胞株IDのSHA256並べ替えに使う番号。答えを見て有利な分け方を選ぶための値ではありません。
- 情報漏洩(リーク)
- 評価用の答えや同じ細胞株の関連行が学習に混じり、性能が良く見えること。同じ細胞株の全薬剤を一緒に分割し、混入を防ぎます。
計算と検証条件を詳しく見る
データ・前処理・分割
NCI/DTPの既知6薬剤(doxorubicin、cisplatin、paclitaxel、fluorouracil、methotrexate、etoposide)のGI50集約値。薬剤ごとにNumExp最大の最高濃度条件群を採用し、応答値で条件を選びません。補助群を除き、6薬剤共通の細胞株を使います。3株未満の前立腺群2株を除外しました。
単位log10(M)とendpoint GI50を検証し、pGI50に符号反転。panel番号+cell番号の重複、名前・組織の矛盾を拒否します。入力SHA256は前回と一致。薬剤別の最高濃度と集約実験数は集計JSONに記録しています。
各分割は学習37株/222行、校正9株/54行、test9株/54行。組織ごとに細胞株IDのSHA256順で約60/20/20%に分離。同じ細胞株の全薬剤は同じ分割へ。薬剤は分割間で共通なので、未見評価は既知薬剤に対する未見細胞株です。未知化合物の評価ではありません。
モデル・不確実性・計算資源
予測 = 薬剤の学習平均+組織残差の縮小平均。組織内の残差和を(行数+10)で割る固定係数10の縮小を使用。今回モデル変更・ハイパーパラメータ探索・testによる選択はありません。
校正細胞ごとに6薬剤の最大絶対残差を取り、80%の有限標本補正分位点を区間の半幅とします。9校正株ではceil((9+1)×0.8)=8番目の値。厳密な分布自由の保証には交換可能性などの条件が必要ですが、層化分割・不均一な集約実験のためここでは保証しません。
MAEの区間はtest細胞株を単位に200回bootstrapした記述的95%区間。関連する6薬剤行をまとめて再標本化します。分割同士は評価株が重なり得るため、5件の独立試行として合成した検定や信頼区間は出していません。
標準Python、CPU1スレッド・低優先度。保存済み約1.16MBのデータを再利用し追加取得なし。今回3計算の実測合計0.154秒、各上限60秒。GPU・有料計算・常駐処理はありません。描画用ライブラリは計算本体とは別です。
まだ分からないこと、次に必要な検証
新たな独立データでの再現、原実験/プレート単位の分離、別施設のデータでの評価、濃度上限による打ち切りへの対応が必要です。現在のXMLは集約値で、実験日・培養時間・共有プレートを完全には復元できません。薬剤ごとの最高濃度も異なります。
まず元実験条件や打ち切り情報が得られるかを調べ、条件を揃えた評価を設計する段階です。さらに同じ分割を増やすだけでは独立性の不足を解消できません。未知化合物・生体内・臨床効果は未検証で、合成や臨床使用へ結び付ける結果ではありません。
出典・記録・旧結果
全5分割の集計JSON・由来・checksum / 結果Markdown / 前回2026-10-05の結果をそのまま見る
出典:NCI/DCTD Data / Compound Inhibition Bulk Data Download。NCI再利用方針は一般テキストの方針で、データ固有の再配布権を確認したとは扱いません。公開するのは集計結果と方法だけで、生XML・細胞株別表・非公開コードは含みません。
再現手順と更新履歴
実験コードcommit cd1040556093c032e768548510d3daecba3e2bd3 と同じchecksumのキャッシュを持つMAEN作業コピーで実行します。本体は非公開で、公開閲覧者に完全な実行環境が提供されているとは主張しません。
nice -n 15 python3 maen.py run --seed 20261006 --out runs/seed6
nice -n 15 python3 maen.py run --seed 20261007 --out runs/seed7
nice -n 15 python3 maen.py run --seed 20261008 --out runs/seed8
2026-10-04:初版。2026-10-05:2分割の比較と公開結果サイト。2026-10-06:事前固定3分割を追加、5件全てを掲載。平易な読み方と専門説明を追加。